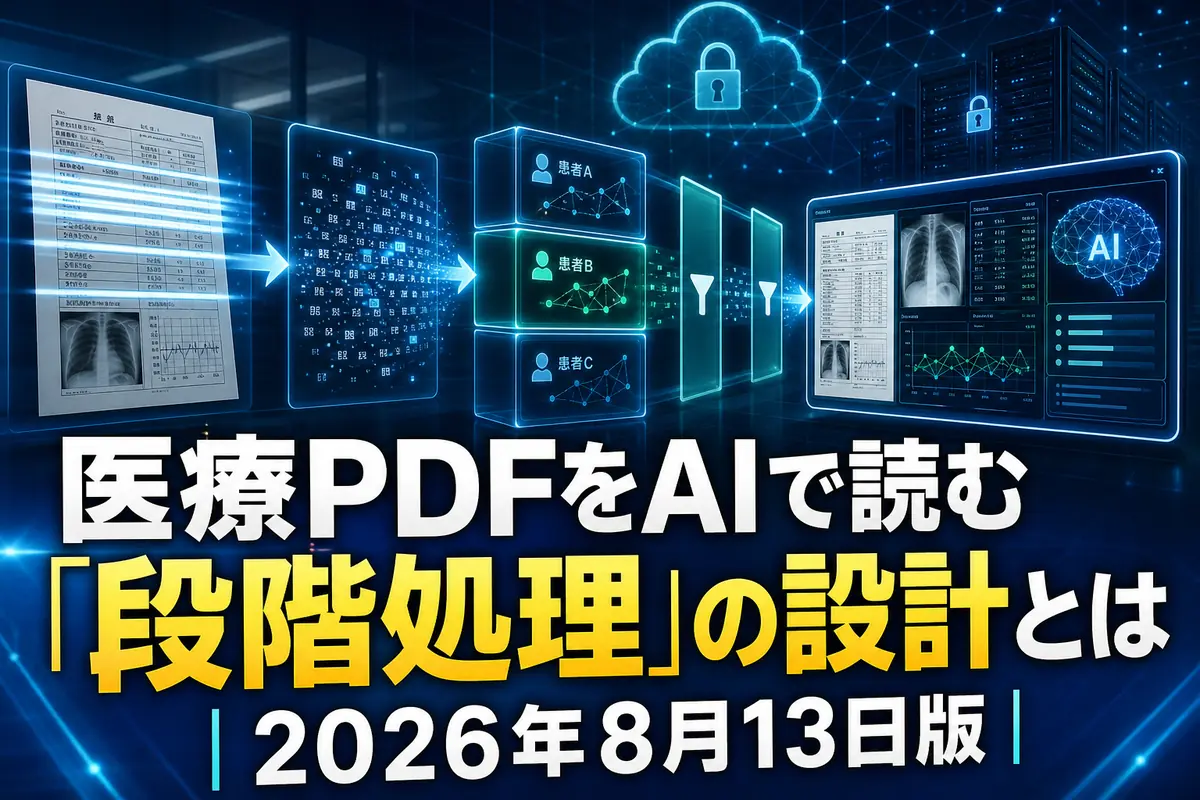
医療PDFをAIで読む「段階処理」の設計とは|2026年8月13日版
医療文書のAI処理で重要なのは、高性能モデルに全ページを読ませることではありません。OCR、検索、軽量モデル、マルチモーダルモデルを順に使い、難しいページだけへ計算資源を集中させることです。
米Guardoc Healthが長期療養施設向けに構築した仕組みは、その考え方を具体的に示しています。手書き、チェック欄、表、押印が混在するPDFを段階的に絞り込み、最終判断を元ページまでたどれる形にしています。
- OCRだけでは失われるレイアウトや手書き情報を、画像も読めるモデルで補う
- 患者ごとに検索範囲を分け、別人の記録が混ざらないようにする
- 軽量な処理で候補を減らし、高コストな推論は最後に限定する
- AIの出力を診断ではなく、文書確認とリスク発見の支援に使う
医療PDFは、文字を抜くだけでは読めない
AWSが2026年7月27日に公開した事例によると、Guardoc Healthは熟練看護施設や介護付き居住施設の臨床文書をAmazon NovaとAmazon Bedrockで処理しています。
対象となる文書は整然とした電子データばかりではありません。
- 印刷文と医師の手書き注記が同居する複数ページのPDF
- チェック欄の状態が保険承認を左右する事前承認書
- 表、自由記述、スキャン画像に分散した薬剤情報
- 署名、押印、訂正線を含む患者受け入れ書類
通常のOCRは文字列の抽出には向きますが、「どの欄にチェックがあるか」「手書き注記が印刷済みの選択を上書きしているか」といった視覚的な関係を落とすことがあります。
Guardocのピーク時の処理量は1日100万文書超とされています。この規模では、条件検出の誤りが1%でも、毎日数千件の記録に影響しかねません。求められるのは単純な自動化ではなく、大量処理、精度、追跡可能性を同時に成立させる設計です。
7段階で「読むべきページ」を絞り込む
Guardocの中核は、患者の記録から関連箇所を検索してモデルへ渡すRAGです。ただし、全文をそのまま検索する一般的な構成より細かく役割を分けています。
1.OCRと臨床単位の分割
最初にAmazon TextractがPDFから文字、手書き、表、フォーム、ページ上の配置情報を抽出します。
抽出結果は固定文字数ではなく、薬剤一覧、診断欄、医師メモなどの意味がまとまる境界で分割されます。文章の途中で機械的に切ると、検索で見つかった断片だけでは診療上の文脈を判断できないためです。
2.患者単位でベクトルを分離
各断片はAmazon Titan Text Embeddings V2でベクトル化され、Amazon DynamoDBに保存されます。ここで重要なのが、データを患者ごとに分割する設計です。
検索対象を最初から一人の患者に限定すれば、共通の巨大なベクトル索引から探す構成に比べ、別人の類似記述を取得する危険を抑えられます。医療データでは、検索精度だけでなく検索範囲そのものの隔離が安全策になります。
3.安価な処理から順に候補を減らす
次に文書種別、作成時期、患者の状況を使う事前フィルターで不要な文書を除外し、k近傍法による検索で関連度の高い断片を探します。
その後の流れは次の通りです。
- 検索結果から関連ページの参照先だけを取得する
- Amazon Nova 2 Liteで明らかな非該当ページを除く
- 残ったページの元PDFをAmazon Nova Proへ渡す
- レイアウト、手書き、署名、押印、チェック欄を含めて最終分類する
- 判定結果を根拠となった元ページへ結び付ける
この階層化により、埋め込みと軽量モデルが大量の候補を処理し、計算量の大きいマルチモーダル推論は難しいページだけを担当します。
ここがポイント: 本番の文書AIでは「最も賢いモデルを全件に使う」のではなく、安価な処理で対象を絞り、難例だけを高性能モデルへ送る構成が、費用と精度の両方を支えます。
OCRとマルチモーダルAIを競わせない
薬剤情報の抽出では、OCRと生成AIのどちらか一方を選ぶのではなく、得意分野を組み合わせています。
Amazon Textractは、印字が鮮明な表や標準的な薬剤一覧を高速に構造化します。Amazon Nova Proには、その抽出結果と元のPDFを一緒に渡します。
Nova Proが補うのは、次のような難例です。
- 折り返された表の列をまたぐ薬剤名や用量
- 印刷された一覧への手書きの追加
- 標準形式ではない表
- 医師の自由記述に埋もれた服薬情報
- 訂正線、押印、署名を含む欄の状態
つまりOCRは文字と構造を機械可読にし、マルチモーダルモデルは元ページを見て空間的な関係を解釈します。既存のOCRを捨てるのではなく、その出力をAIの判断材料にする点が実装上の要所です。
公表された成果はどう読むべきか
AWSの事例では、Guardoc導入先の四半期分析について、平均46%の文書誤り削減、監査罰金の70%減、1施設当たり年間40万ドル超のROIが報告されています。
別の2施設・患者200人を対象とした四半期導入では、847件の文書訂正と、米国の熟練看護施設向け報酬制度に影響する86件の問題への対応が示されました。7施設・居住者1,618人の事例では、10,612件の問題を検出したとしています。
ただし、これらはGuardocとAWSが紹介した導入結果です。製品一般の性能保証として読むべきではありません。施設ごとの文書品質、対象業務、人による確認方法、比較期間などで結果は変わります。
導入評価では、少なくとも次を分けて測る必要があります。
- 見逃しをどれだけ抑えられたかを示す再現率
- 検出結果のうち正しかった割合を示す適合率
- 文書形式別の失敗率
- 人による再確認へ回した割合
- 誤り1件が患者、請求、監査へ与える影響
日本の医療・介護現場への示唆
この事例を日本でそのまま移植できるわけではありません。帳票、診療報酬・介護報酬、個人情報保護、電子カルテとの接続条件が異なるためです。
それでも、処理方式には応用できる点があります。
開発者が見るべき点
患者や利用者ごとに検索範囲を隔離し、出力には根拠ページを必ず付ける設計が重要です。さらに、帳票種別ごとの再現率と適合率を別々に測り、信頼度が基準未満なら人へ戻す経路が欠かせません。
医療・介護事業者が確認すべき点
クラウドサービスが規制対応の対象になっているだけで、利用者側の法令順守が自動的に完成するわけではありません。AWSも、米国の保護対象医療情報を扱う場合にはBAAの締結と対象サービスの適切な設定が必要だと説明しています。
日本で検討する際も、保存場所、アクセス権限、監査ログ、データ保持期間、委託契約、人による最終確認の責任を具体的に決める必要があります。
現場担当者への影響
AIが担うのは診断そのものではなく、文書から確認候補を拾い、根拠ページへ案内する役割です。看護師や事務担当者にとっては、全ページを読み直す作業を減らせる一方、警告が多すぎれば確認負担が増えます。
精度の平均値だけでなく、「誰が、どの警告を、何分で確認するか」まで業務設計に含める必要があります。
継続ウォッチ
今後は、モデル性能の向上よりも、本番運用での境界条件が焦点になります。
- 劣化したスキャンや非標準帳票を人へ戻す基準
- 元ページとAI出力を結ぶ証跡の保存方法
- 複数文書をまたぐ推論での患者データ隔離
- 施設外の電子カルテや薬局システムとの接続
- 導入企業の報告とは独立した精度検証
Guardocは、記録支援、ケアプラン、入所手続き、薬剤照合などへの拡張を計画しています。次に見るべきなのは機能数ではありません。文書形式ごとの誤り率、人へ戻す割合、根拠を追跡できない判定の扱いが公開されるかどうかです。