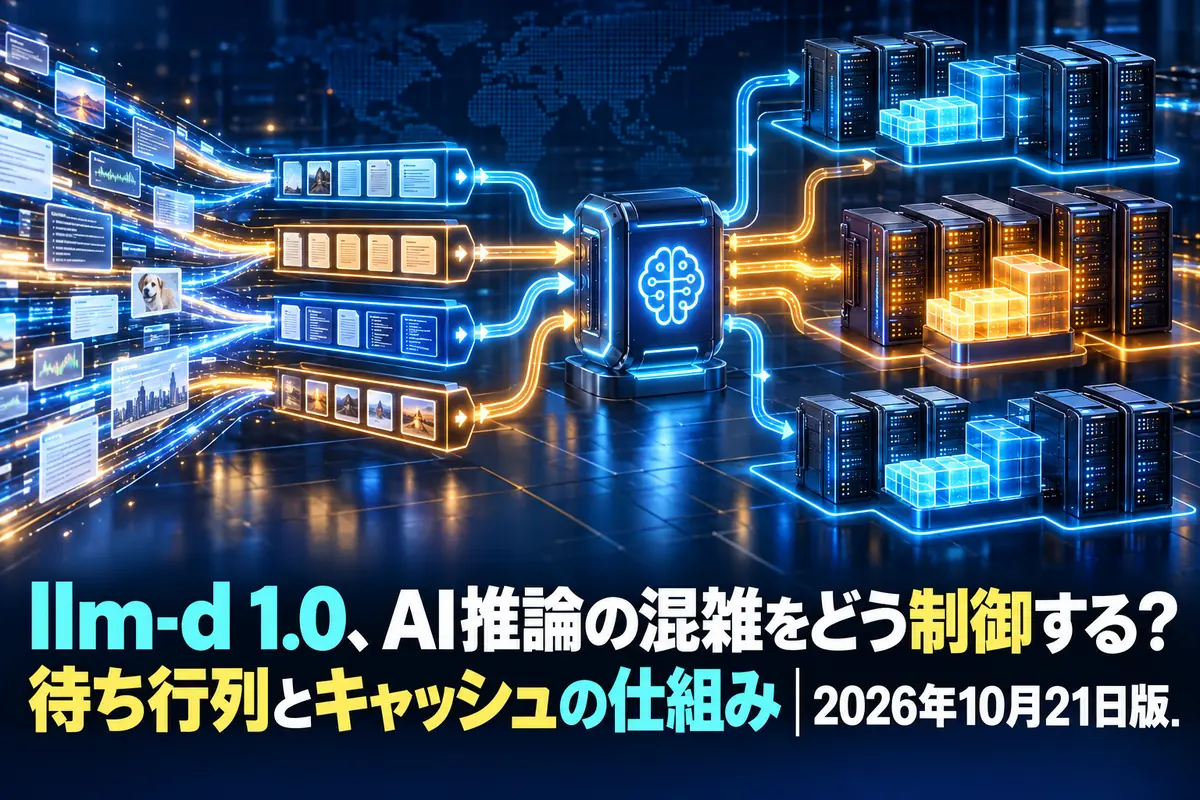
llm-d 1.0、AI推論の混雑をどう制御する?待ち行列とキャッシュの仕組み|2026年10月21日版
AIへの問い合わせが集中したとき、GPUを増やす以外にも打てる手があります。要求をどこで待たせ、どの計算結果を再利用し、誰の処理を先に通すかを変えることです。
2026年10月20日に発表された分散推論基盤「llm-d 1.0」は、この制御を本番運用向けに強化しました。対話、文書処理、AIエージェントが同じ計算資源を使う環境で、混雑時の応答や更新中の稼働を支えるリリースです。2026年10月21日、日本時間時点の公式資料をもとに、その仕組みを整理します。
- 混雑対策:要求を入口側で待たせ、優先度と利用者ごとの公平性を制御する。
- 再計算の削減:入力の計算結果を保持するサーバーへ、関連する要求を振り分ける。
- 運用の改善:入力処理と生成処理を分けた構成でも、互換性を確認しながら更新する。
llm-dはモデルを動かすサーバー群の「交通整理役」
llm-dは、新しい言語モデルではありません。vLLMやSGLangなどの推論エンジンを束ね、要求の振り分けや計算資源の利用を制御するオープンソースの基盤です。
推論エンジンがモデルの計算を実行する一方、llm-dのルーターは、サーバーの負荷やキャッシュの所在を見て送り先を選びます。単純に順番で振り分けるよりも、LLMの処理に合わせた判断ができる構成です。公式アーキテクチャ
例えば、短い質問と長大な文書の要約では、同じ「1リクエスト」でも負荷が違います。入力の長さも、生成が続く時間も異なるためです。APIの呼び出し回数だけをそろえても、利用者が受ける待ち時間はそろいません。
混雑した要求を、GPUへ送る前に待たせる
今回の中心は、要求の待ち行列を入口側で制御する仕組みです。
モデルサーバーへ要求を送り込みすぎると、それぞれのサーバー内に待ち行列ができます。いったんそこへ入った要求を、後から別の空いたサーバーへ回すことは難しくなります。
llm-dのFlow Controlは、混雑時の要求をルーター側に保持します。送り先を決めるタイミングを遅らせることで、空きができたサーバーや、再利用できるキャッシュを持つサーバーを選ぶ余地を残します。
優先度と公平性を別々に扱う
処理の順番は、主に次の段階で決まります。
- 優先度の高い区分を選ぶ。
- 同じ優先度の中で、利用者や業務ごとの公平性に基づいて選ぶ。
- 選ばれた待ち行列から、次の要求を取り出す。
企業内で使うなら、顧客対応の対話と、急がない夜間の文書処理を区別する設計が考えられます。ただし、Flow Controlは明示的な有効化が必要です。1.0へ更新するだけで、自社の業務優先度が反映されるわけではありません。
また、この機能は計算能力そのものを増やしません。容量を超える要求が続けば、誰かは待ちます。公式文書も、生成中の応答を守る代わりに、開始前の待ち時間が増える場合があると説明しています。Flow Controlの仕様と制約
同じ文脈を使う要求は、キャッシュのある場所へ
もう一つの柱が、過去の計算結果を利用するルーティングです。
LLMの推論では、入力を処理して得たAttentionのキーとバリューを「KVキャッシュ」として保持します。入力の共通部分を再利用できれば、その部分を最初から計算し直す負担を減らせます。
llm-dは、このキャッシュの所在を考慮して要求を振り分けます。さらに、GPUメモリーだけでなく、CPU側のメモリーやストレージを使う階層的なキャッシュ管理も備えています。KVキャッシュ管理の公式説明
会話の継続と負荷分散を両立させる
1.0の発表では、複数ターンの会話を、既存のキャッシュを持つサーバーへ寄せるセッション対応が示されました。ただし、そのサーバーが飽和すれば振り分け直します。
ここには実務上の判断があります。同じ場所へ送り続ければ再利用しやすい一方、混雑した場所に固定すると待ち時間が伸びるからです。
AIエージェントのように、同じ指示や作業履歴を引き継いで何度も推論する用途では、単発の生成速度に加えて、この再利用と分散の兼ね合いが重要になります。llm-d 1.0の発表
入力処理と生成処理を分けると、更新にも調整が要る
LLM推論は、大きく二つの段階に分かれます。
- Prefill:入力を読み込み、生成に必要な状態を計算する。
- Decode:その状態を使って、出力をトークン単位で生成する。
llm-dは、これらを別のワーカー群へ分ける構成に対応しています。公式資料では、計算負荷が中心となるPrefillと、メモリー帯域の影響を受けやすいDecodeを分離する設計として説明されています。
ただし、分ければ管理対象も増えます。入力処理側だけが先に更新され、生成側と組み合わせられない状態を避けなければなりません。
1.0で紹介されたDisaggregatedSetは、両者を一つの論理的な単位として管理します。更新状態と準備完了を確認し、互換性のある組み合わせへ要求を送る仕組みです。高速化のために分割した構成を、継続して運用するための制御でもあります。DisaggregatedSetの公式文書
日本の開発現場では、平均速度より混雑時の挙動を確かめる
直接の対象は、オープンモデルを自社やクラウド上で配信する基盤担当者です。外部の生成AIサービスを使う一般ユーザーが、手元で設定する機能ではありません。
導入を評価するなら、単発の短い質問だけでなく、実際の業務が重なる条件で比較する必要があります。
- 対話の使いやすさ:文書処理が集中しても、最初の応答までの時間や生成中の間隔を守れるか。
- 利用者間の偏り:一部の部署が大量送信したとき、ほかの部署の待ち時間がどう変わるか。
- キャッシュの効果:同じ文脈を繰り返す業務と、毎回異なる入力で差が出るか。
- 更新と再試行:更新中の失敗を検出し、アプリ側で安全に再試行できるか。
Flow Controlの待ち行列はメモリー上にあり、障害時まで要求を永続保存する仕組みではありません。公式文書も再起動や停止時の扱いを説明しているため、基盤側の可用性とアプリ側の再試行を合わせて確認すべきです。
継続ウォッチ:速さを守る設定と、残る障害対応
llm-d 1.0は、モデルを高速に動かす技術に、複数業務を同居させるための制御を重ねました。次に確かめたいのは、その制御が自社の要求の長さや混雑の仕方に合うかです。
- 優先度を設定した結果、低優先度の業務が長時間待ち続けないか。
- キャッシュを優先する設定と、空いているサーバーを使う設定のどちらが実測で有利か。
- 今後の課題として挙げられたルーターのActive-Active構成や、推論要求のフェイルオーバー・移送がどう進むか。
最初の比較では、同じモデル、同じハードウェア、同じ入力群を使い、対話とバッチ処理を同時に流す。そのうえで利用者別の待ち時間と失敗率を比べると、今回の変更が役立つ場面を見極めやすくなります。