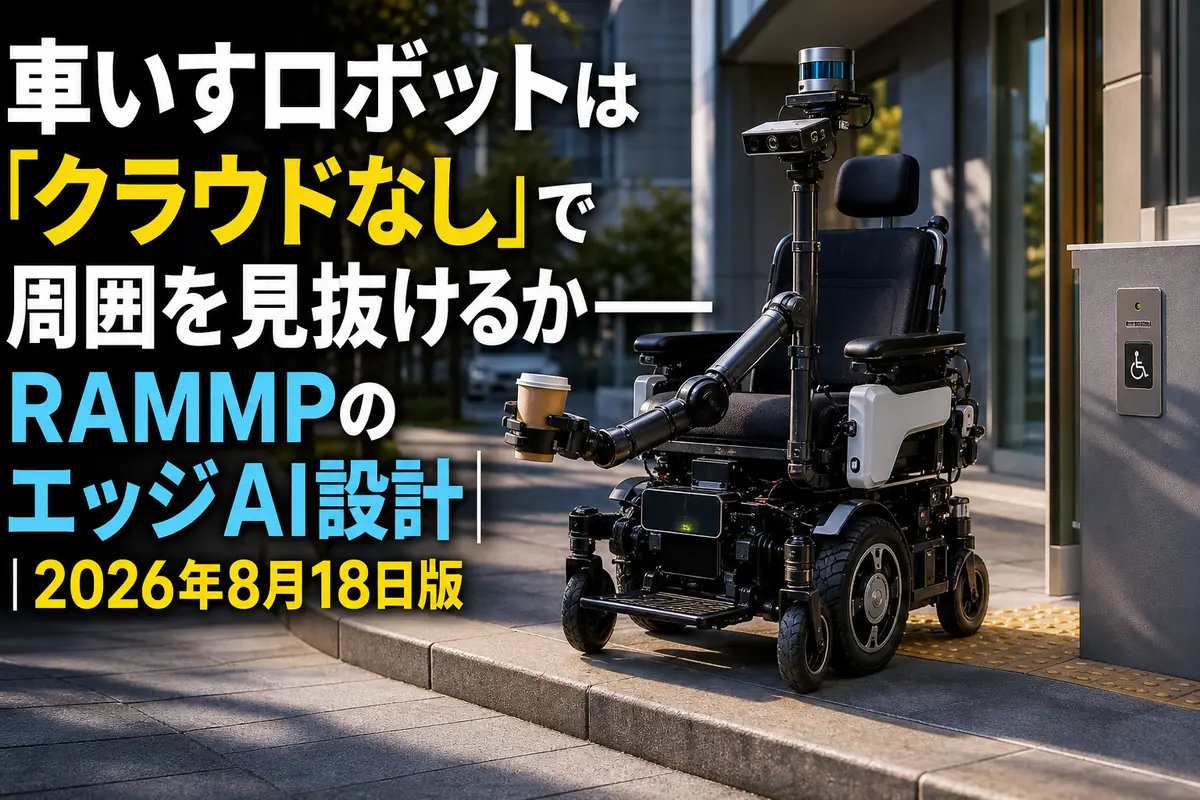
車いすロボットは「クラウドなし」で周囲を見抜けるか――RAMMPのエッジAI設計|2026年8月18日版
車いす型ロボットが縁石やコップ、自動ドアのボタンを見分け、その場で移動や把持を支援する。米ピッツバーグ大学の研究チームが開発する「RAMMP」は、この処理をクラウド任せにせず、端末側で動かそうとしています。
核心は、巨大な視覚モデルをそのまま載せることではありません。汎用モデルで学習データを作り、軽量な検出モデルを実機で動かす役割分担です。通信遅延や圏外の影響を抑えながら、バッテリー、発熱、安全性という現実の制約に向き合う設計です。
- RAMMPは移動機構、ロボットアーム、360度の環境認識を統合する研究プロジェクト
- SAMで画像のラベル付けを効率化し、DINO系モデルの視覚表現を物体検出へ生かす
- 実機では軽量なRF-DETRを使い、速度と消費電力を優先する
- 次の焦点は、照明や視点が変わっても判断がぶれない時間的一貫性と安全性
RAMMPが目指す支援ロボット
RAMMPは「Robotic Assistive Mobility and Manipulation Platform」の略称です。ピッツバーグ大学Human Engineering Research Laboratories(HERL)を中心に、移動支援と物体操作を一つのシステムへまとめようとしています。
ピッツバーグ大学によると、試作機には段差へ対応する車いす型の移動機構と、7自由度のロボットアーム、カメラや各種センサーが組み込まれています。米国の医療研究機関ARPA-Hによる支援額は、5年間で最大4,150万ドルです。
想定される動作は具体的です。
- 縁石や地面の状態を認識して移動を補助する
- カメラでコップやドアの開閉ボタンを見つける
- 利用者が音声やタッチで対象物を選ぶ
- ロボットアームで日用品をつかむ
単に目的地まで走るだけではありません。「移動する」「対象を見つける」「手を伸ばす」を連続した支援にすることがRAMMPの特徴です。
視覚AIを実機へ載せる仕組み
RAMMPの技術的な要点は、学習時と実行時でモデルの仕事を分けていることです。
SAMが教師データを増やす
ロボットに物体を検出させるには、画像の中にあるコップ、縁石、ボタンなどの位置を示した学習データが必要です。しかし、車いすのカメラが見る高さや角度、照明、背景は一定ではありません。人手だけで大量の画像へ正確な印を付ける作業には時間がかかります。
そこで使われるのが、画像内の対象領域を切り分けるMetaのSegment Anything Model(SAM)です。RAMMPチームはSAMを自動ラベル付けに利用し、異なる角度、高さ、背景、明るさを含む訓練画像を効率よく整備しています。
SAMが実機を直接操縦するわけではありません。検出モデルを育てるためのデータ作成を支える役割です。
DINOの視覚表現を検出へ移す
DINOは、すべての画像に人手のラベルを付けなくても、画像同士の関係から汎用的な視覚表現を学べるモデルです。RAMMPでは、DINOv2の埋め込み表現を活用してRF-DETRという軽量な物体検出モデルを調整しています。
この構成には、次の利点があります。
- 少ない専用データから対象物の特徴を学びやすい
- 汎用的な視覚表現を複数の検出タスクへ再利用できる
- 実機ではタスクに絞った軽量モデルを動かせる
Metaの説明では、DINOv3も小型の「視覚の基盤」として利用し、その上に物体検出や動き追跡などの軽量モジュールを重ねる方向が示されています。ただし、RAMMPで現在説明されている検出系はDINOv2の埋め込みを使ったRF-DETRであり、DINOv3やSAM 3.1の統合強化は今後の作業です。
端末側で処理する理由
歩道へ人が飛び出したときや、進行方向に段差が現れたとき、映像を遠隔サーバーへ送り、結果を待つ設計では通信状況が反応時間を左右します。RAMMPはカメラ画像とセンサーデータを端末側で処理し、ネットワークへ常時依存しない認識を目指しています。
一方、小型でバッテリー駆動の機器には計算資源の上限があります。チームはメモリー使用量の削減、低精度演算、実用的な画像解像度、効率的なバッチ処理を組み合わせ、境界の細かな精度と処理速度のバランスを取っています。
ここがポイント: 支援ロボットでは、最高精度のモデルを載せることより、必要な対象を遅れず安定して認識し、電池切れや通信断の場面でも動けることが重要です。
デジタルツインで危険な試験を減らす
RAMMPは実機だけで開発を進めるのではなく、「RAMMS」と呼ばれるシミュレーション環境も利用します。車いす型ロボットと周囲の環境を仮想空間へ再現し、制御や認識を現実的な条件で試すためのデジタルツインです。
この仕組みが重要なのは、失敗の影響が大きいからです。段差の判定やロボットアームの動作を、利用者が乗った実機だけで繰り返し試すことはできません。仮想環境なら、地形、障害物、照明などの条件を変え、危険を抑えながら検証ケースを増やせます。
ただし、シミュレーションで成功しても実世界で同じ結果になるとは限りません。カメラの汚れ、逆光、床面の反射、予期しない人の動きといった差を、実機試験で埋める必要があります。
利用者にとって何が変わるのか
この技術が狙うのは、完全自動の車いすに利用者がすべてを任せることではありません。利用者の指示とロボットの自律機能を組み合わせ、操作に必要な負担を減らすことです。
たとえば、利用者が画面上でコップを細かく指定し、アームの各関節を一つずつ操作する代わりに、「テーブルのコップ」と音声で伝える。視覚AIが対象を絞り、ロボット側が把持動作を補助できれば、操作の切り替え回数を減らせます。
影響を受ける主体も、利用者だけではありません。
- 利用者:移動と物体操作を一つの機器で行える可能性がある
- 介助者:日用品の把持や環境確認など、一部の反復支援を機械へ分担できる
- 臨床・福祉担当者:利用者ごとに自律動作の範囲や入力方法を調整する役割が増える
- 開発者:平均精度だけでなく、誤検出時の停止、手動介入、監査記録まで設計する必要がある
HERLは車いす利用者、臨床家、支援団体を設計過程へ参加させています。支援機器では、研究室で動くことと、利用者が安心して日常生活へ持ち込めることの間に大きな隔たりがあるためです。
実用化までに残る課題
RAMMPは研究開発中のシステムであり、一般販売されている製品ではありません。現時点で確認すべきなのは、派手なデモよりも、認識が不安定になる条件と失敗時の挙動です。
時間的一貫性
動画では、同じ物体がフレームごとに別の対象として認識されたり、輪郭が揺れたりすることがあります。移動中のロボットでは一瞬の正解率だけでなく、連続した判断が安定しているかが重要です。
誤検出時の安全設計
コップを見落とすことと、段差を見落とすことでは危険度が違います。対象ごとに停止、再確認、利用者への問い合わせを切り替える設計が必要です。AIの信頼度が低い場面で、人へ制御を戻せることも欠かせません。
個人差への適応
利用者によって、音声、タッチ、スイッチなど使いやすい入力方法は異なります。自律機能をどこまで許可するかも一律ではありません。精度向上と同時に、利用者が制御権を理解し、変更できるインターフェースが求められます。
継続ウォッチ
次に見るべきなのは、モデル名や単独ベンチマークの更新ではありません。実生活に近い条件で、システム全体がどこまで安定するかです。
- DINOv3とSAM 3.1がRAMMPの実機系へどう統合されるか
- 逆光、混雑、雨天、通信断などの条件別評価が公開されるか
- 誤検出やセンサー異常時の停止・手動介入手順が示されるか
- 利用者参加型テストの結果が製品要件へどう反映されるか
RAMMPが示しているのは、フィジカルAIの性能がモデル単体では決まらないということです。学習データの作り方、端末上の軽量化、シミュレーション、安全な制御、人が介入できる操作系がつながって初めて、視覚AIは日常の移動支援に近づきます。次の重要な一歩は、実環境テストで失敗条件と回復方法を具体的に示すことです。